
Научный семинар Искусственный интеллект Машинное обучение
- Дата проведения: 8 мая 2026
- Длительность: 1:21:02
- Спикеры: Артём Артурович Липиньски
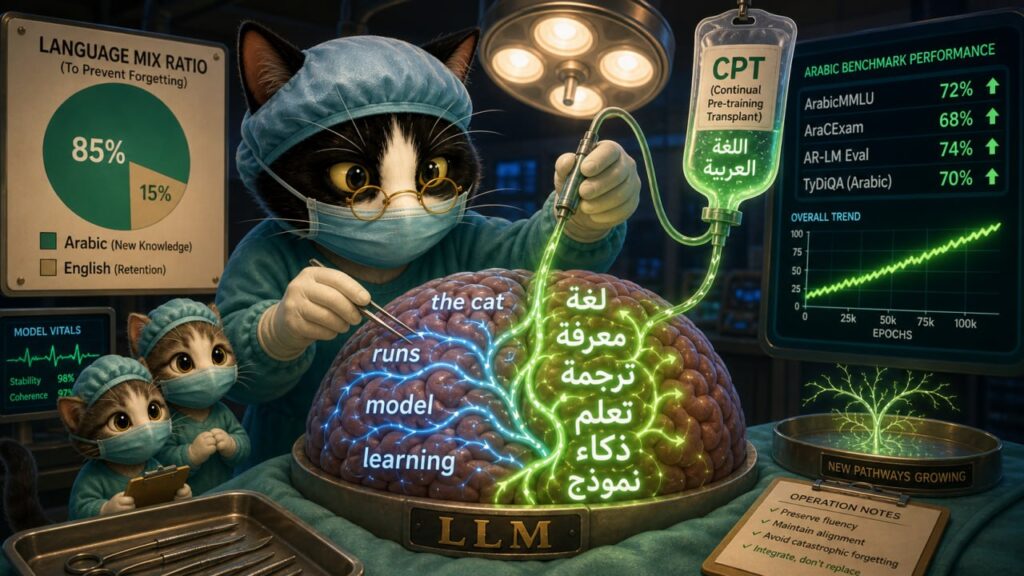
Арабский язык — один из крупнейших в мире по числу носителей, однако современные языковые модели работают с ним заметно хуже, чем с английским или китайским. Причина проста: качественных арабских данных в открытом доступе катастрофически мало, а существующие модели обучались преимущественно на англоязычных текстах.
В докладе будет представлена работа по созданию арабской языковой модели, которая способна осмысленно понимать и генерировать текст на арабском, при этом оставаясь достаточно компактной для практического применения.
Будет рассмотрено:
— как собрать и подготовить большой качественный корпус текста с нуля;
— почему смешение языков в обучающих данных помогает, а не мешает;
— полный pipeline адаптации LLM к новому языку, от сбора данных до SFT (с разбором того, как эффективно пройти каждый этап и каких ошибок избежать).
Результаты работы актуальны для всех, кто занимается адаптацией LLM к низкоресурсным языкам: подходы применимы далеко за пределами арабского.