
Научный семинар Искусственный интеллект Машинное обучение
- Дата проведения: 13 февраля 2026
- Длительность: 2:01:34
- Спикеры: Сергей Николенко, ПОМИ РАН, СПбГУ
2025 год стал очень важным для безопасности искуственного интеллекта: теоретические опасения превратились в эмпирически подтверждённые угрозы, ведущие лаборатории впервые добрались до реальных протоколов ответственного масштабирования, а государства начали обращать внимание на то, что развитие AI несёт не только преимущества, но и риски.
В докладе мы разберём ключевые результаты года: прорывы в механистической интерпретируемости (circuit tracing в Claude, транскодеры вместо SAE), несколько ярких примеров эмерджентного рассогласования (emergent misalignment), хрупкой, но критически важной возможности мониторинга цепочек рассуждений и тому, как легко её потерять, и так далее, и тому подобное.
Мы обсудим, как модели учатся хитрить, прятать свои способности (sandbagging) и даже шантажировать пользователей, чтобы избежать отключения. Поговорим о новой парадигме AI control, которая честно признаёт, что мы пока не умеем гарантировать согласование (alignment) и должны делать пессимистичные предположения о намерениях AI-моделей. А из хороших новостей поговорим о сотрудничестве в области AI safety между Anthropic и OpenAI, активации ASL-3 для Claude Opus 4 и новуой конституции Claude, которая довольно сильно расширяет предыдущую.
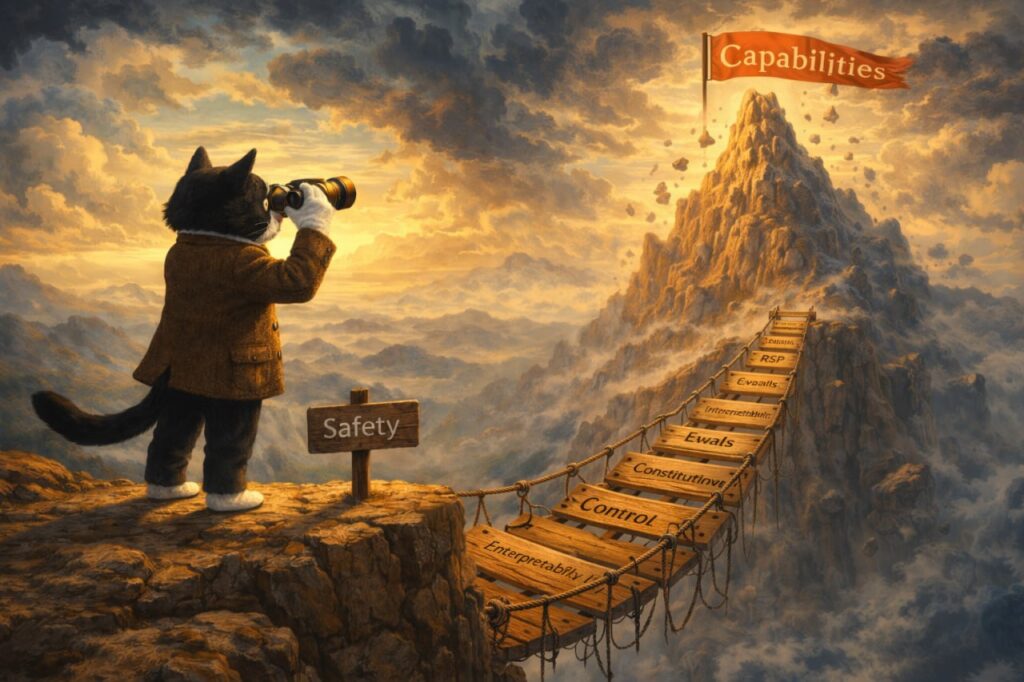
Впрочем, несмотря на некоторые позитивные результаты, честный итог 2025 года таков: прогресс в безопасности есть, но возможности AI-моделей и, как следствие, проблемы растут куда быстрее. По текущим оценкам, к 2027 году AI-агенты смогут автономно выполнять задачи, на которые у человека уходит целый рабочий день. Готова ли к этому инфраструктура безопасности? Приходите, обсудим.