
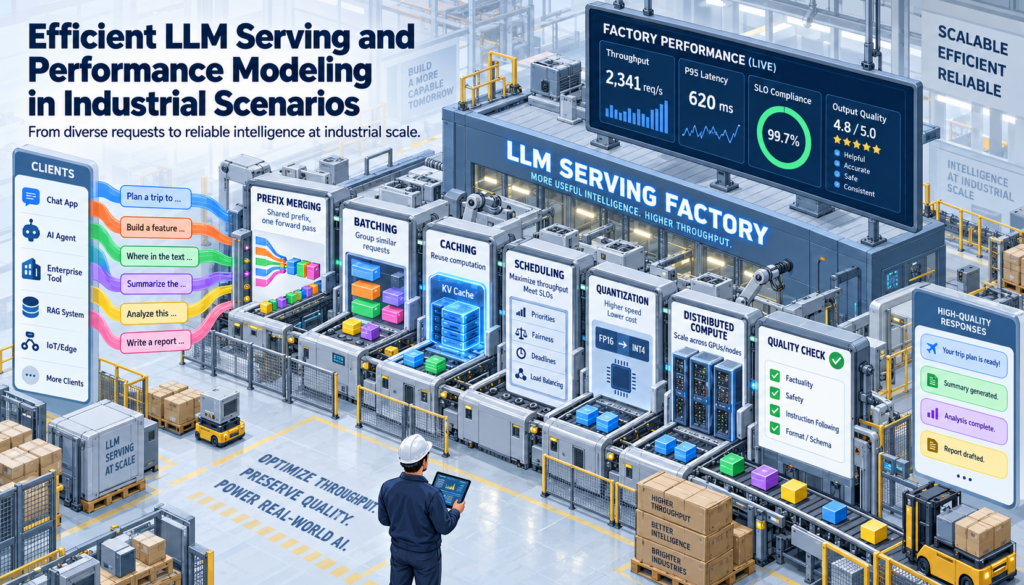
Сценарии реального применения больших языковых моделей, в том числе в составе облачных сервисов, существенно отличаются от лабораторных сценариев наличием многопоточного входного трафика, состоящего из гетерогенных потоков запросов от разных клиентов – среди которых могут быть и клиенты, отправляющие запросы с большим общим префиксом, что особенно часто встречается в агентских сценариях. Целью данного направления является исследование модификаций движков для инференса больших языковых моделей (LLM inference engines), направленных на увеличение пропускной способности модели при условии соблюдения целевых показателей обслуживания (service-level objectives, SLO), а также сохранении качества ответов, генерируемых моделью.
Помимо этого, в рамках направления исследуются методы оценки производительности и соблюдения системой SLO в offline-режиме, то есть без необходимости предварительной реализации рассматриваемых архитектур в составе движка для инференса.